VIDEO
『NTE: Neverness to Everness』Ver.1.4バージョンPV「名もなき祈歌」
左から、Zheng Shengwen氏、Shi Jinwei氏
World Partitionの事前ロードでテレポート時のロード待ちを解消
講演の前半では、UE5のパフォーマンス最適化を担当するShi氏が、シームレスなロードやMass EntityによるNPCの最適化について解説しました。
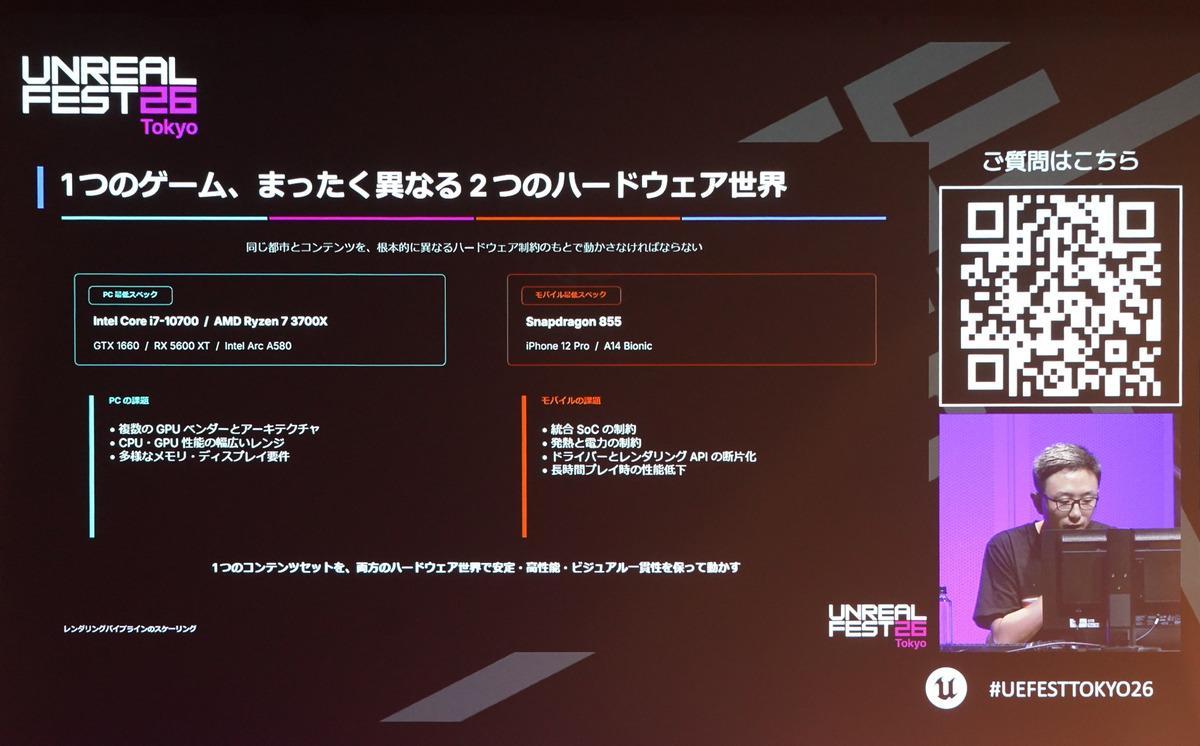
高密度に作り込まれた都市をPCとモバイルの双方で動かすには、CPU側で処理時間やメモリの使い方を管理し、GPU側では各プラットフォームに合った描画処理を組み立てることが重要だとShi氏はいいます。
大規模なオープンワールドでは、プレイヤーが遠方へテレポートすると目的地のロードが追いつかず、到着と建物や地面の表示にタイムラグが生じることがあります。
その対策として、『NTE』では専用のロード機構を別途作ったり、メモリ上にワールドを2つ保持するなどの手法は採らず、UE標準のWorld Partition を利用。プレイヤーがテレポートする前に、目的地の座標へ一時的な「Streaming Source(※)」を差し込み、目的地周辺のデータを先行ロード しています。※ World Partitionがレベル内のどの範囲を読み込むかを決める基準点。通常はプレイヤーの位置を基準とする
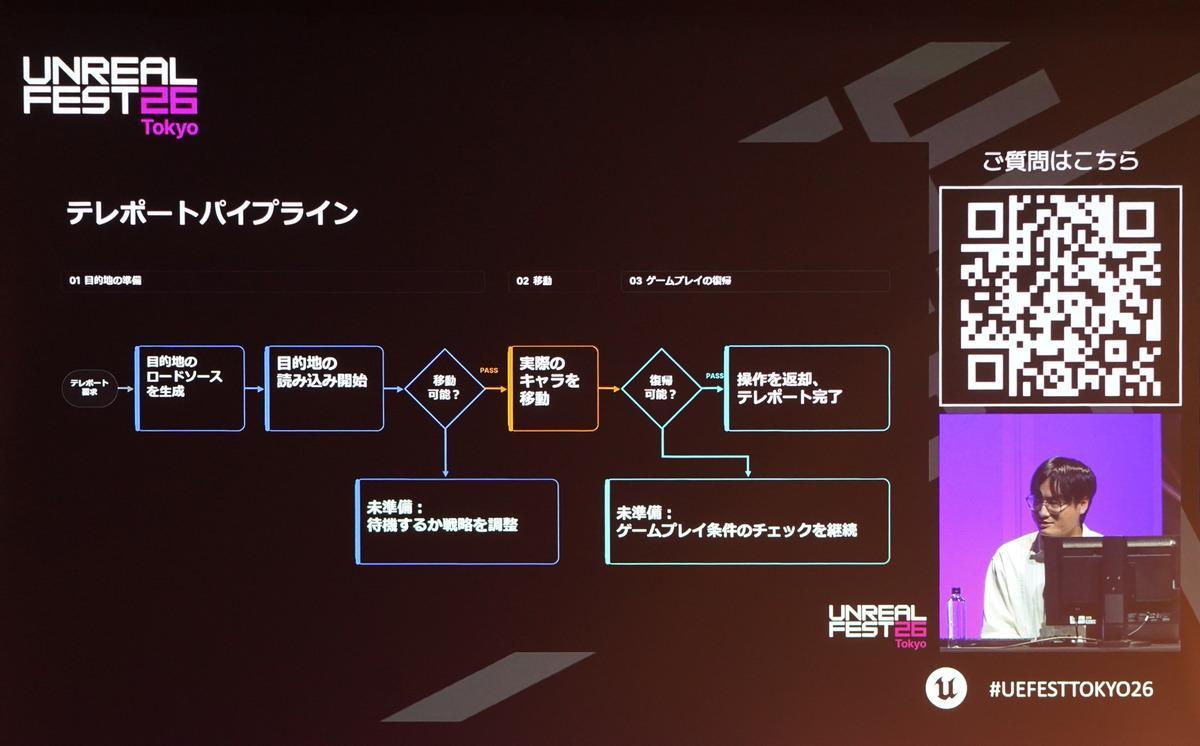
この一連の処理は、「事前読み込み」「移動」「ゲームプレイ復帰」を状態として管理するステートマシン で制御します。紹介された実装では、バウンディングボックスへの進入をきっかけに、対象のData Layerを有効化して読み込みを開始します。
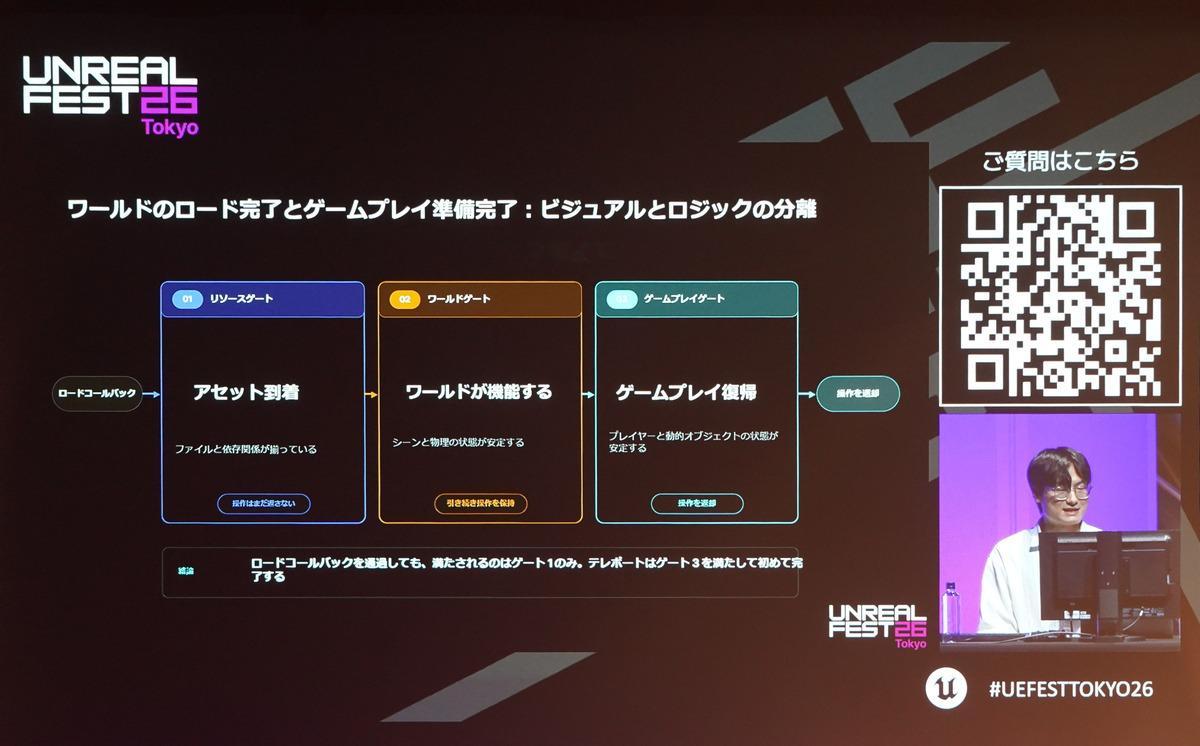
テレポート後にプレイヤー操作の受付を再開するまでには、「リソース」「ワールド」「ゲームプレイ」の3段階 に分けて判定します。
まず、非同期ロード完了のコールバックによって、リソースの読み込み完了を検知。次に、World Partitionの有効化すべきセルが表示状態になったかを検知し、ワールドのストリーミング完了を判定します。
最後に、徒歩移動中であればキャラクターを地面に接地させ、運転中であれば車両の物理シミュレーションとキャッシュ済みデータを復元。その後、プレイヤーに操作権を戻します。
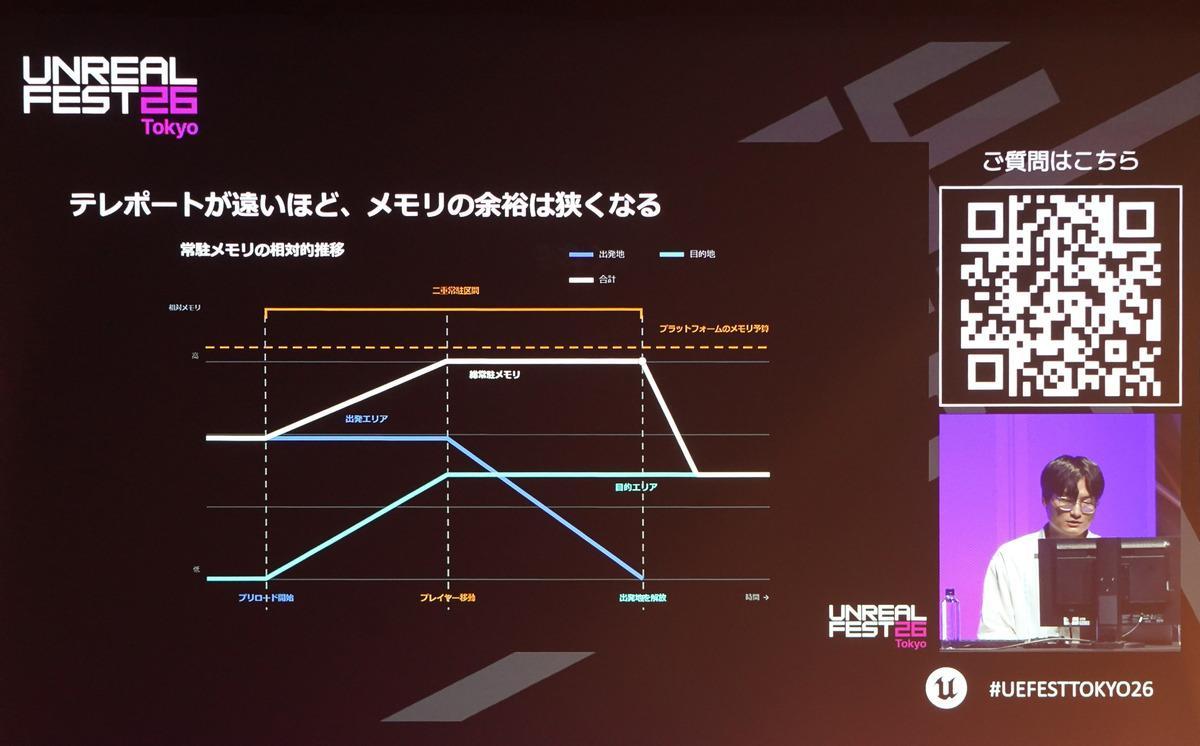
FastGeoでロード時の処理負荷を軽減 目的地を事前にロードすると、出発地と目的地の両方のデータが一時的にメモリに共存します。そこで、先行して読み込む範囲、移動するタイミング、不要になった出発地のデータを解放するタイミングを段階的に制御し、あらかじめ定めたメモリバジェットに収めています 。
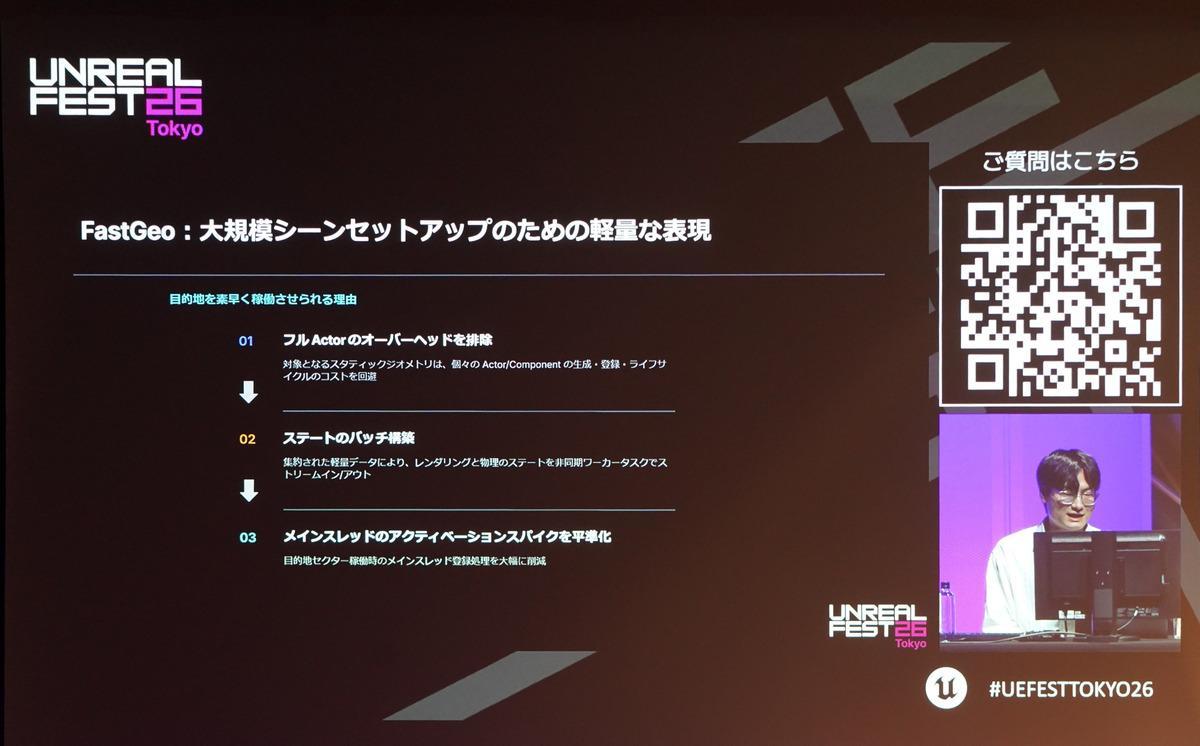
さらに、目的地を有効化する際の処理を軽くするため、UEの「FastGeo(Fast Geometry Streaming) 」を活用。
World Partitionのストリーミング用データを作る段階で、対象となる静的ジオメトリのアクタやコンポーネントを軽量なデータへ変換 し、個々のアクタを生成・管理するオーバーヘッドを削減しています。
また、多くのオブジェクトでは、描画用のデータと衝突判定用のコリジョンデータを分離 しています。コリジョン側は、空間をより細かく区切ったグリッドで管理し、描画とは異なる単位で読み込めるようにしています。
NPCの密度とインタラクションを両立する、Mass Entity⇔アクタの切り替え制御
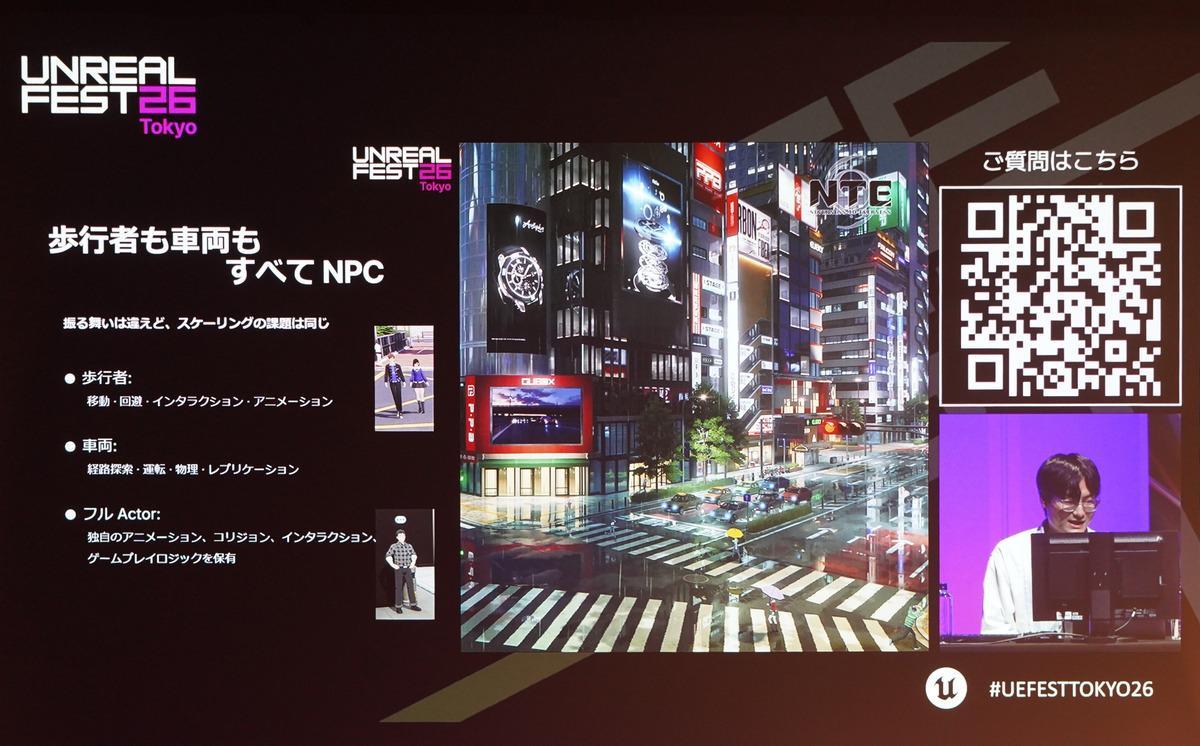
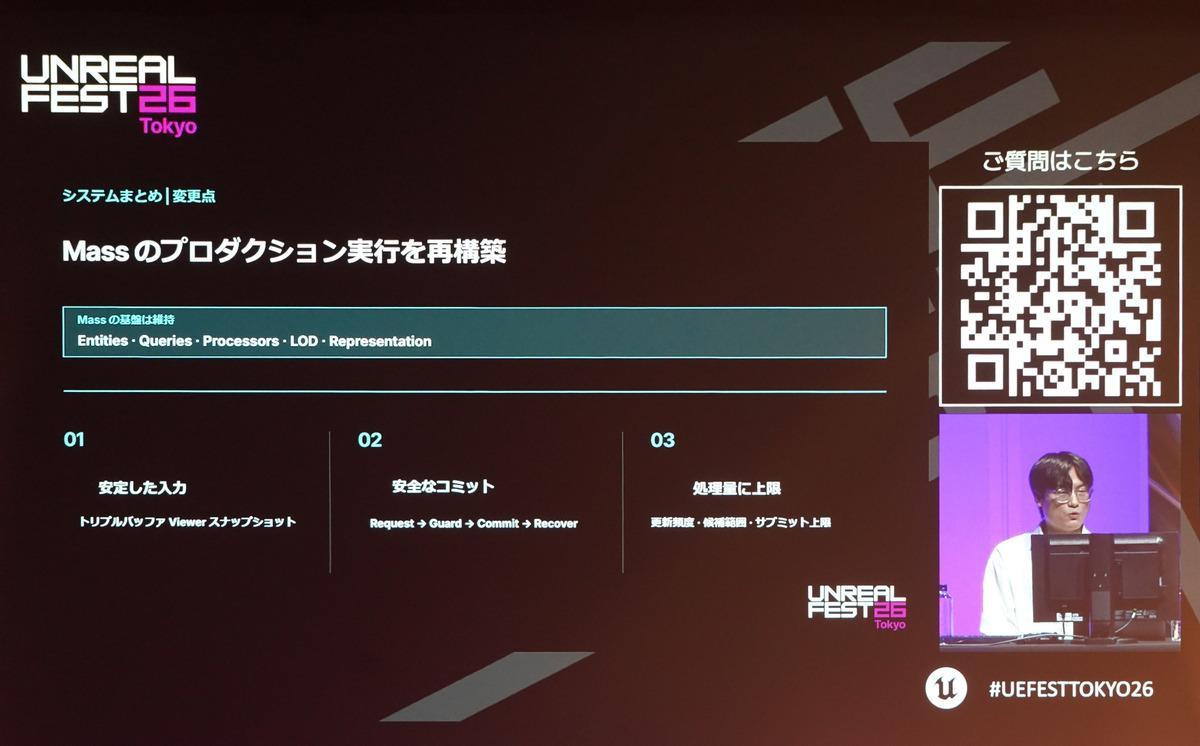
ロードが完了した目的地で、大量のNPCや交通車両を動かすために採用されているのが、UEのデータ指向フレームワーク「Mass Entity」 です。各NPCの位置や速度などのデータをまとめて処理し、多数のシミュレーションを効率よく実行します。
『NTE』では、UE5.5の実装をベースにMass Entityのパイプラインを独自拡張し、その後UE5.6へアップグレードしたといいます。
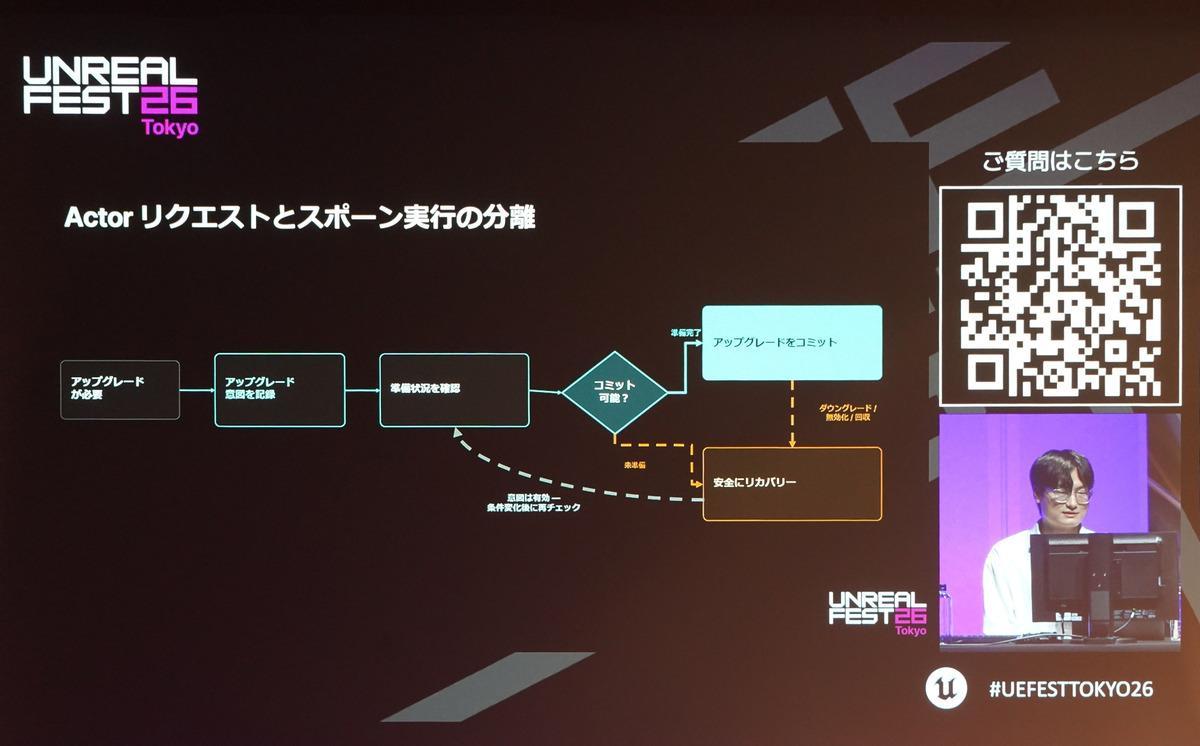
Mass Entityとアクタ間の切り替え処理を複数フレームに分散 Mass Entityの運用で課題となったのが、Mass Entityで管理するNPCをアクタへ切り替える際の負荷です。
『NTE』では、プレイヤーとの位置関係などに応じてNPCをアクタに切り替え、インタラクションなどができるようにしています。ただし、アクタで表現するNPCは、アニメーションやコリジョンやゲームプレイのロジックなどを扱うため、Mass Entityに比べて処理コストが高くなります。
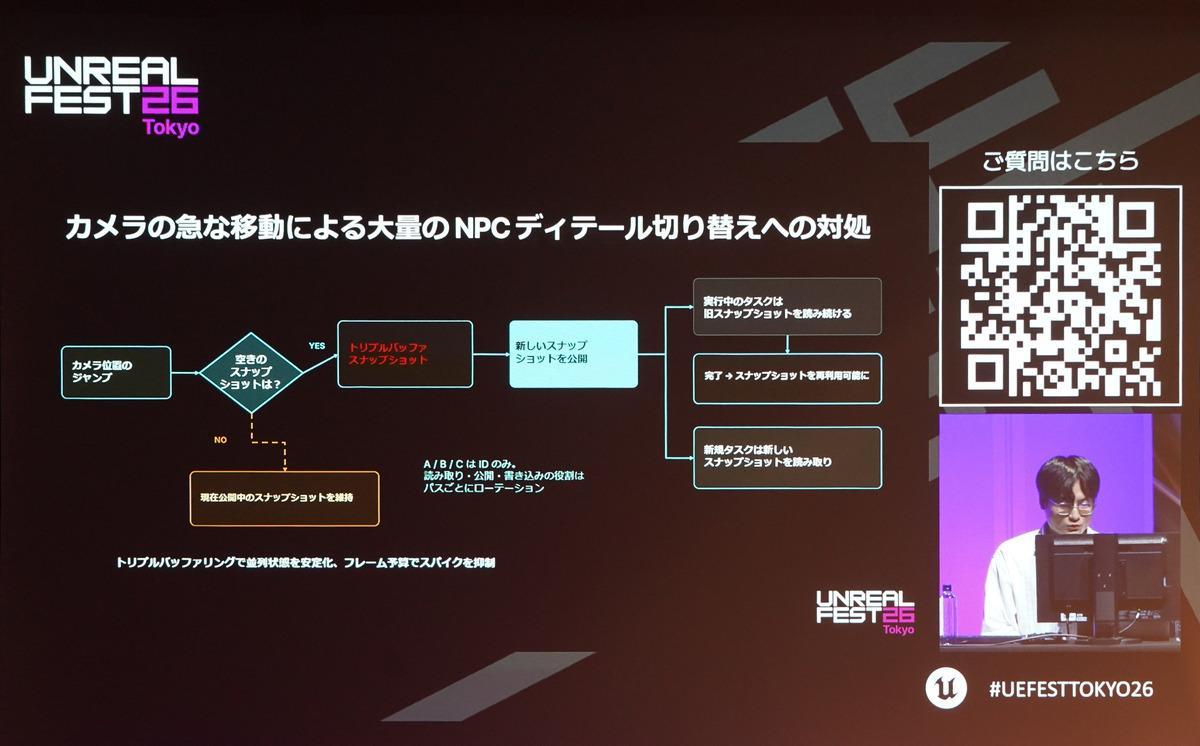
特に、カメラが大きく移動し、多数のNPCを一度にアクタへ切り替える必要が生じると、アクタの生成や初期化が集中し、ゲームスレッドの負荷が急増します。
そこで、重い切り替え処理を複数のフレームへ分散することで、NPCの密度を維持 したまま処理落ちの発生を抑えています。複数フレームへの分散にあたっては、計算中に変わらない入力データの用意 、切り替えを安全に確定する仕組み 、1フレームあたりの処理量を制限する仕組み の3つが必要でした。
トリプルバッファ方式で書き込み・読み取りを競合なく行う UE標準のMass Entityでは、NPCのLOD判定に使用するプレイヤーのカメラなどの位置・向きの情報を「LODSubsystem」が管理しています。本作では、このSubsystemを参照する処理のスレッド制約を見直し、NPCとの距離計算やLOD判定の一部をワーカースレッドで並列実行 できるようにしました。
ただし、LOD判定に使用するカメラ情報は、プレイヤーの移動などに伴って随時更新されます。ワーカースレッドが計算中にこれらのデータが書き換えられると、計算結果の不整合やクラッシュにつながるおそれがあります。
そこで導入したのが、参照カウント付きのトリプルバッファ方式 です。カメラ情報のスナップショットを保持する領域を3つ用意し、更新が完了したデータだけをワーカースレッドに公開。参照中の領域は上書きせず、すべての読み取り処理が終了してから再利用 します。
これにより、ゲームスレッド側でカメラ情報を更新しながら、ワーカースレッド側では確定済みの情報を使ってLOD計算を並列実行できるようにしています。
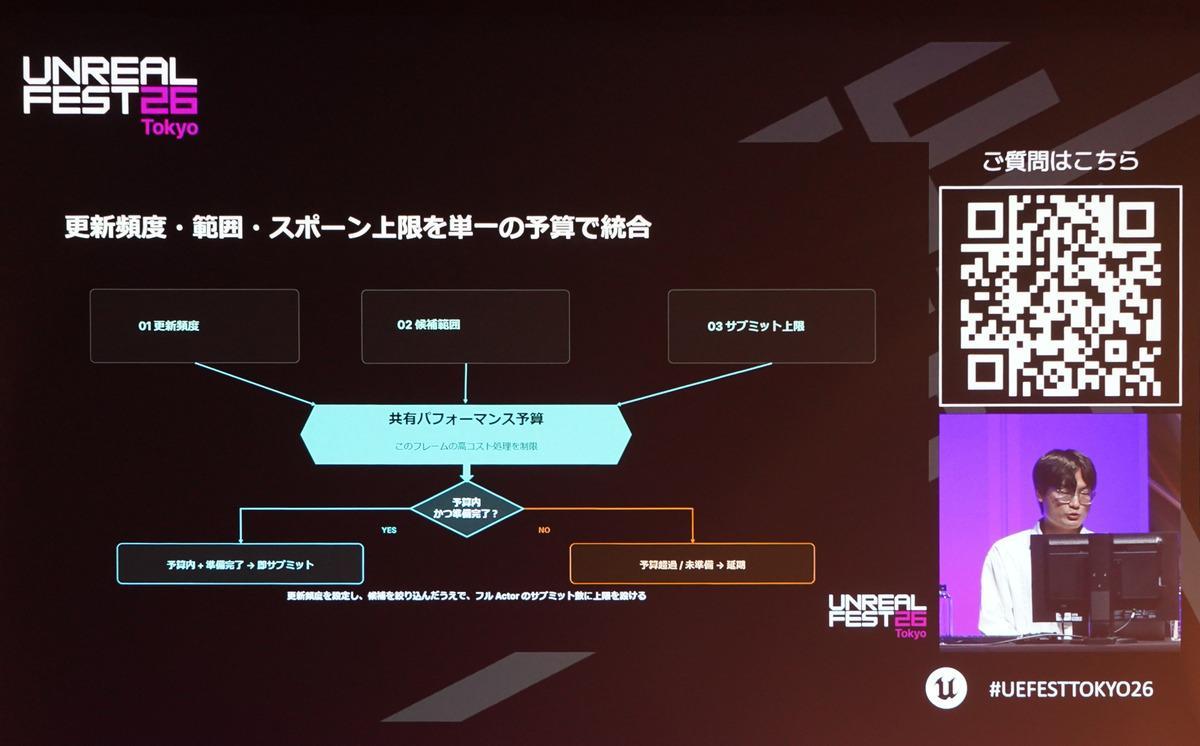
アクタ化の要求と実行を分散し、負荷集中を回避 アクタへの切り替えでは、必要性の判定と、実際の生成・切り替えを分けて管理 しています。各フレームでは、切り替え要求に応じてアクタを新規生成または再利用し、1フレームに使える負荷の余裕などを加味して切り替えを確定します。
切り替えの途中で失敗や要求の取り下げが発生した場合は、条件に応じて「待機」「再試行」「キャンセル」「解放」のいずれかへと分岐する
さらに、更新する頻度 や処理の対象範囲、1フレームに切り替えを確定させる数 を動的に管理し、フレームの処理量を抑えています。
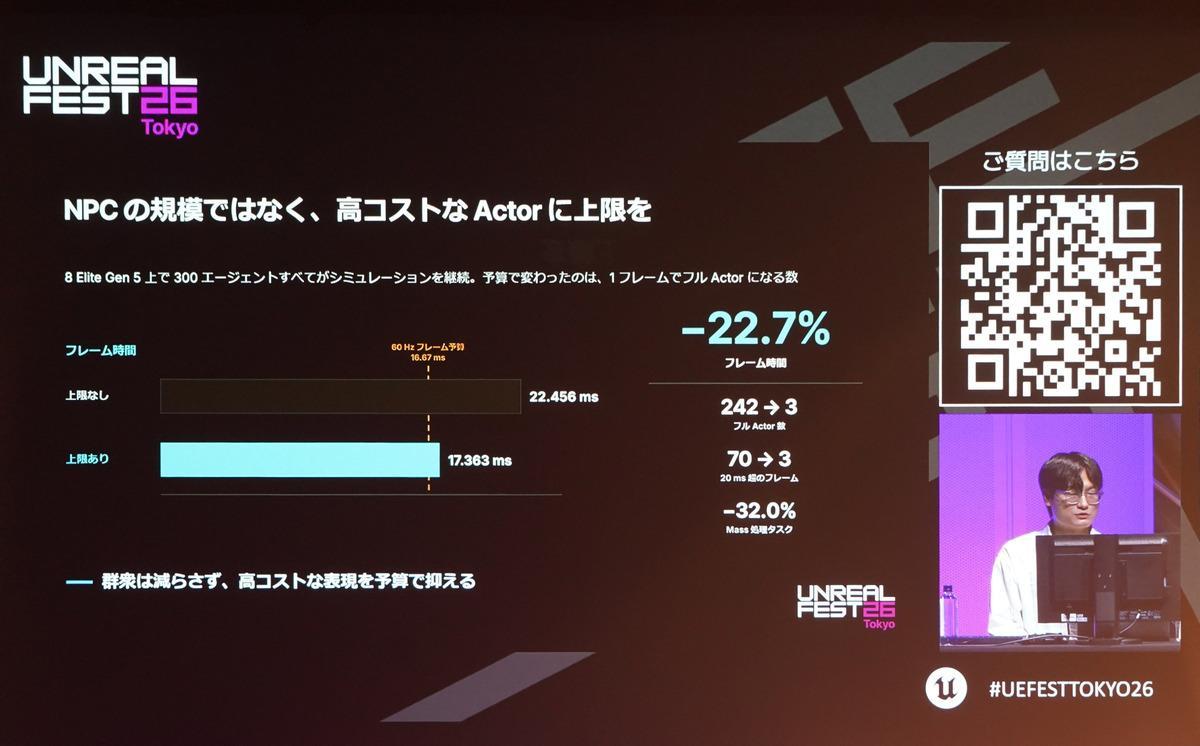
講演では、Snapdragon 8 Elite Gen 5搭載端末で、処理量の上限を設けた場合と設けない場合の比較が示されました。
NPC300体で比較を行ったところ、アクタへの切り替え数に制限を設けた場合はフレーム時間が22.456msから17.363msへと22.7%短縮 されました。1フレーム内でアクタ化する数は242体から3体へ減少し、20msを超えたフレーム数も70から3に減っています 。Mass Entityの処理タスクについても、32.0%の削減が示されました。
モバイルではDepth Prepassなどでレンダリングを効率化
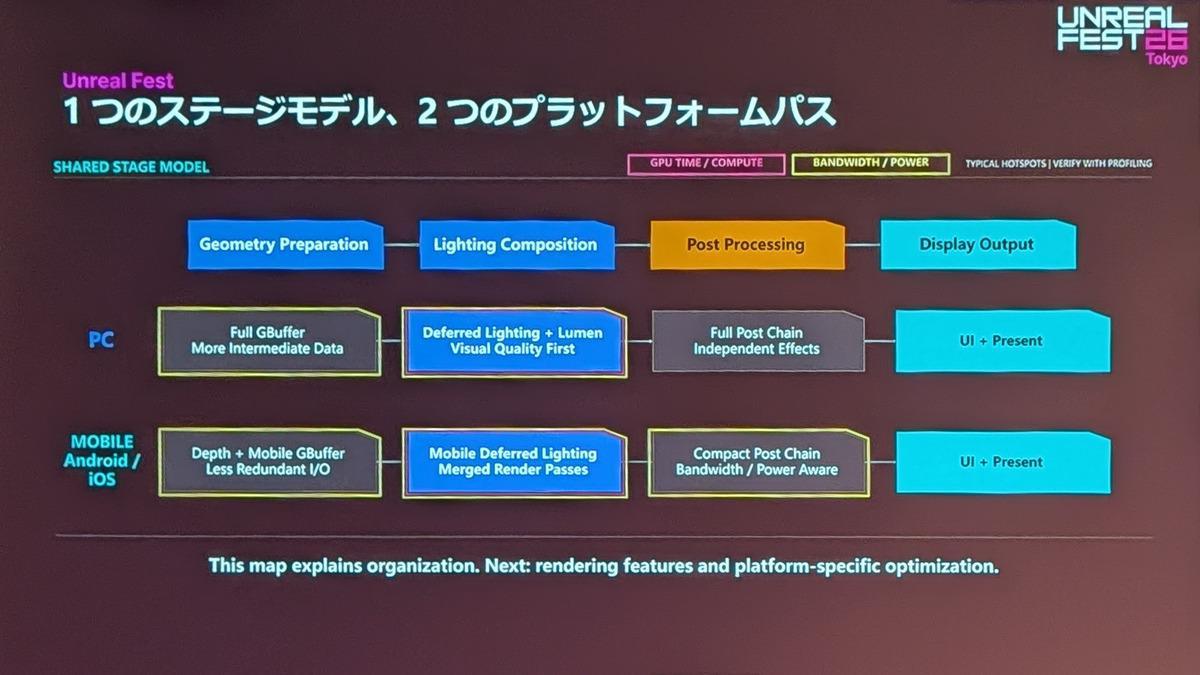
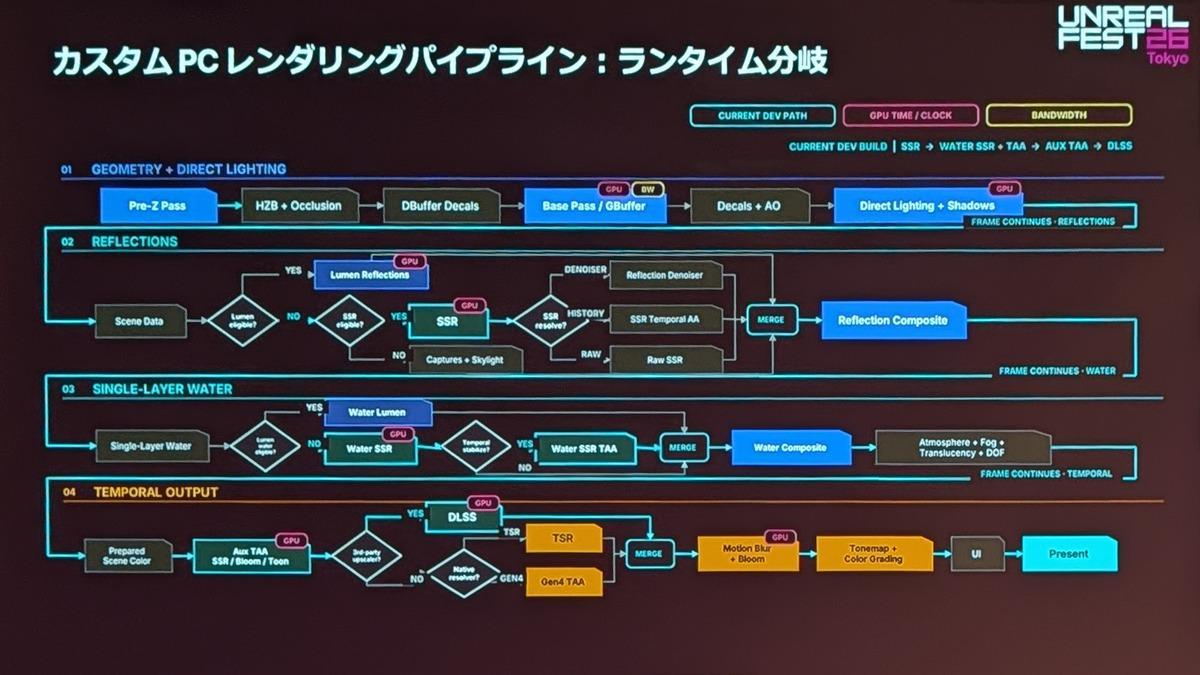
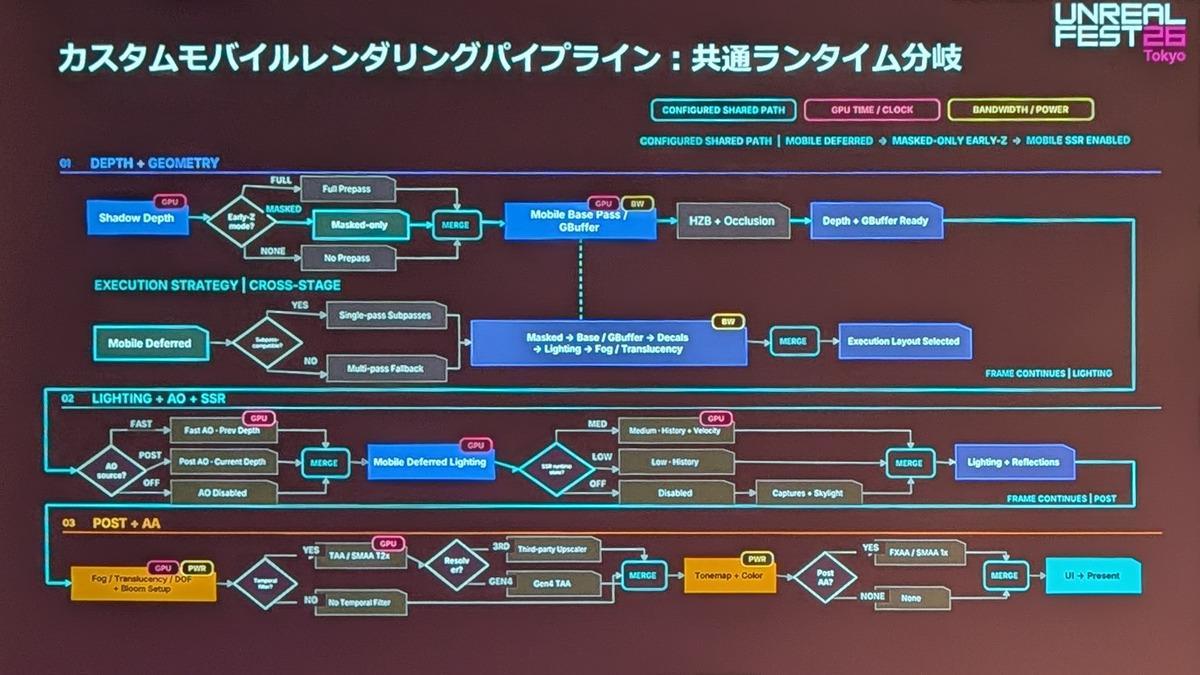
続いてShi氏は、PC版とモバイル版で異なる描画処理フローについて説明。
ジオメトリの準備→ライティングの合成→ポストプロセス→画面への出力という流れは共通していますが、使える演算性能やメモリ帯域、発熱の制約が異なるため、各工程で使う機能やデータの受け渡し方を変えています。
PC版ではグラフィック品質を重視し、Lumenによるライティングやスクリーンスペースリフレクション、各種ポストプロセス、DLSSなどを組み合わせてレンダリングします。
水面表現には、水を表現する専用のシェーディングモデル「Single Layer Water」を使用している
一方、モバイル版では、描画の計算量に加えて、メモリとのデータ転送や発熱を抑えることが重要 です。
計算の無駄を減らす工夫のひとつが「Depth Prepass 」です。オブジェクトのレンダリング前に深度を計算し、遮蔽を早期に判定することで、物体に隠れた部分の無駄なレンダリングを省きます。
また、Vulkanのサブパスなどを活用できる環境では、物体の描画、デカール、ライティングなどを1つのレンダーパス内で連結します。GBufferをGPU内部のタイルメモリに保持し、メインメモリへの書き出しと読み戻しを減らす ことで、データ転送の負荷を抑えています。
ポストプロセスやアンチエイリアスも必要最低限に絞り、描画品質と負荷のバランスを取っています。
本作ではAndroidとiOSの双方で、モバイル向けのディファードレンダリングを採用している
端末の性能と互換性に応じて、画質と描画機能を調整
講演の後半では、Zheng氏が、性能の異なる端末間で共通のコンテンツを扱うために、描画品質を段階的に調整する仕組みを解説しました。
モバイルでは、起動直後の速さだけでは快適さを判断できません。プレイを続けて端末が熱くなると、過熱を防ぐためにCPUやGPUの動作周波数を下げる「サーマルスロットリング 」が働き、性能が低下することがあります。そのため、瞬間的な最高性能に加え、長時間維持できる性能を検査する必要 があります。
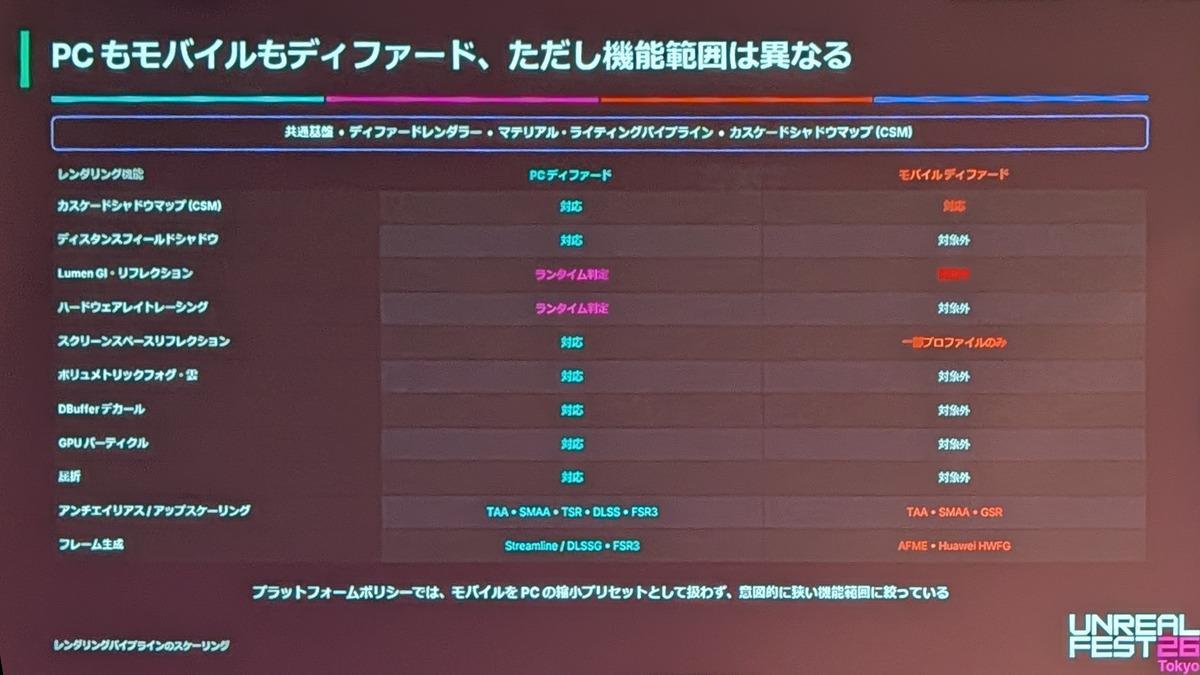
本作は、ディファードレンダラーやカスケードシャドウマップ(CSM)をPCとモバイル共通の土台にしています。
そのうえで、PCではディスタンスフィールドシャドウやボリュメトリックフォグなどを利用する一方で、モバイルは利用する機能の範囲をあらかじめ絞っています。
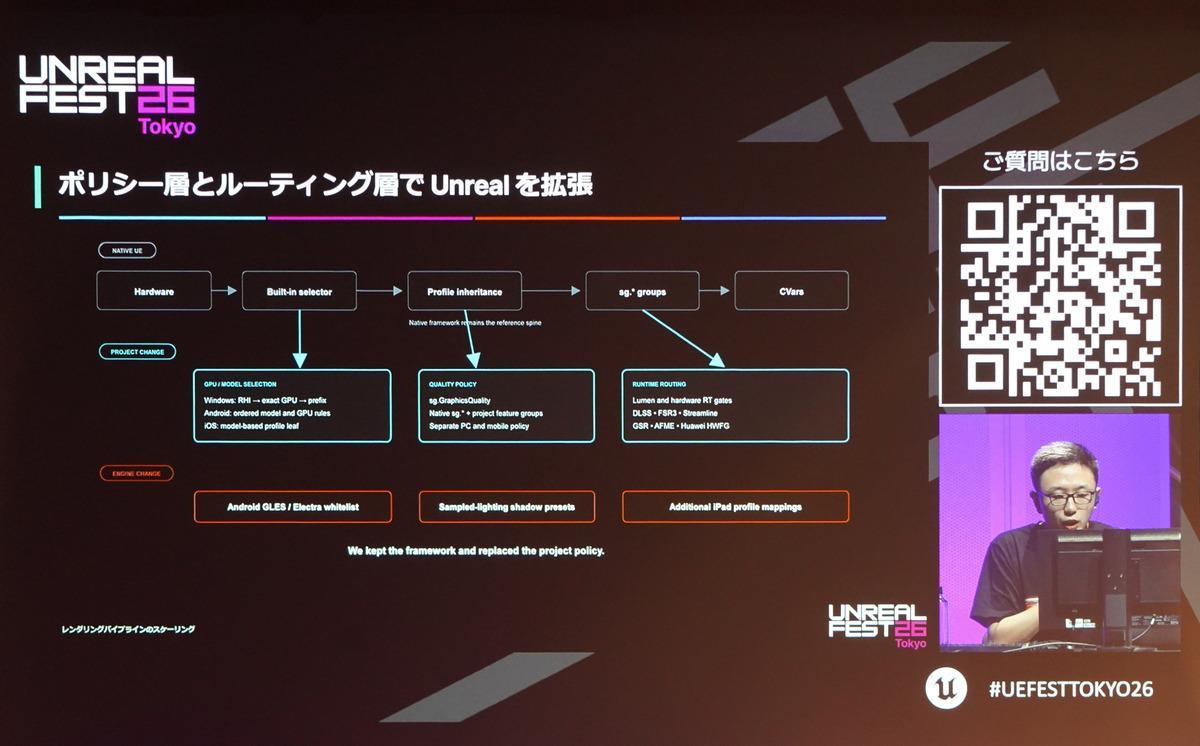
デバイスごとの設定には独自の選択・判定ルールを追加 機種やGPUに応じた画質設定には、UE標準の「Device Profile 」を使用。『NTE』では独自の選択ルールと画質設定を追加し、プラットフォームや性能帯の共通設定を継承しながら、個別の機種にも対応します。
Lumenや超解像、フレーム生成などの機能は、選択された画質設定に加え、ハードウェアの対応状況などを実行時にも確認したうえで有効化 します。たとえば、DLSSの対応条件を満たさないことが実行時に検出された場合は、自動的にTAAに切り替わります。
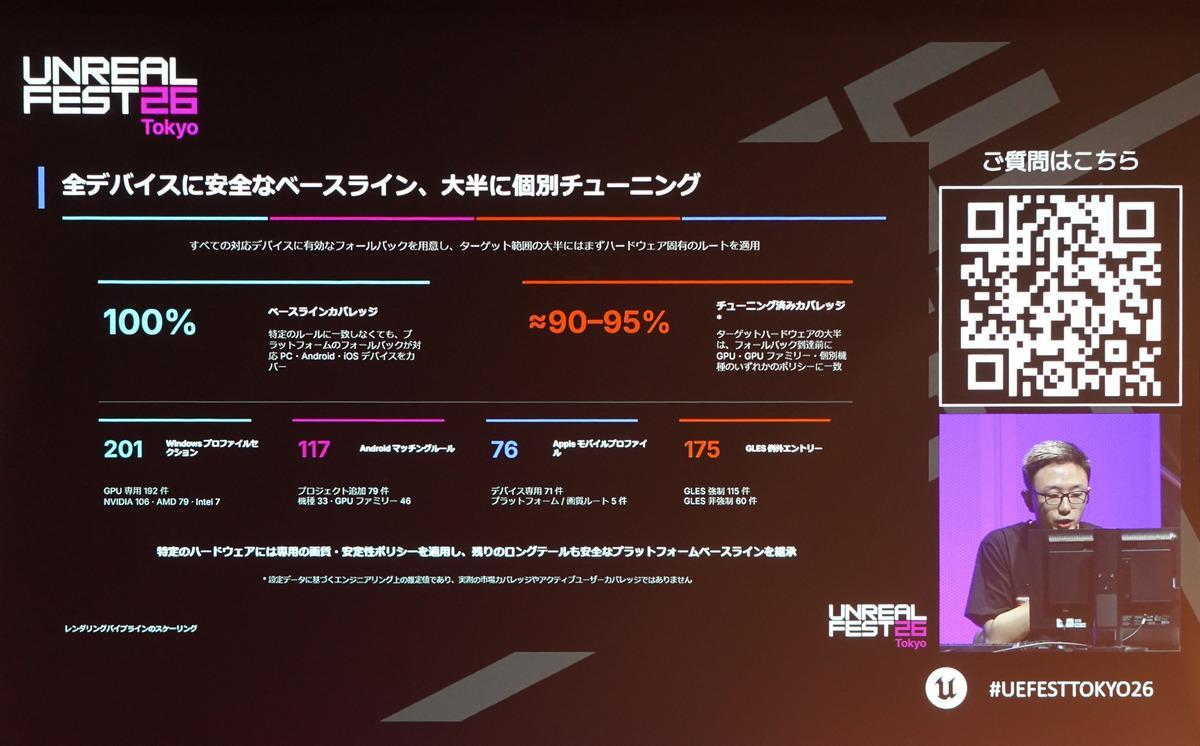
実機の比較テストでVulkanとGLESの例外ルールを決める Android版はVulkanを標準としつつ、端末によってGLES(OpenGL ES)への切り替えや一部機能の無効化で対応 。端末ごとに再現性のある問題が発見されれば、個別のルールに反映します。講演では例として、バックバッファの画像形式に互換性の問題があり、GLESへ切り替えたPixel 6が挙げられました。
対象ハードウェアの推定約90〜95%にはGPUや機種ごとの設定が適用されますが、どれにも一致しない端末には、プラットフォーム共通の基本設定を適用します。
影の更新範囲を絞り、描画負荷を抑える
続いてZheng氏は、シャドウマップを再利用し、レベルに落ちる影の描画負荷を抑える手法を紹介しました。高層ビルが立ち並ぶ都市では、正確な影のレンダリングに大量のオブジェクトを描画する必要があります。
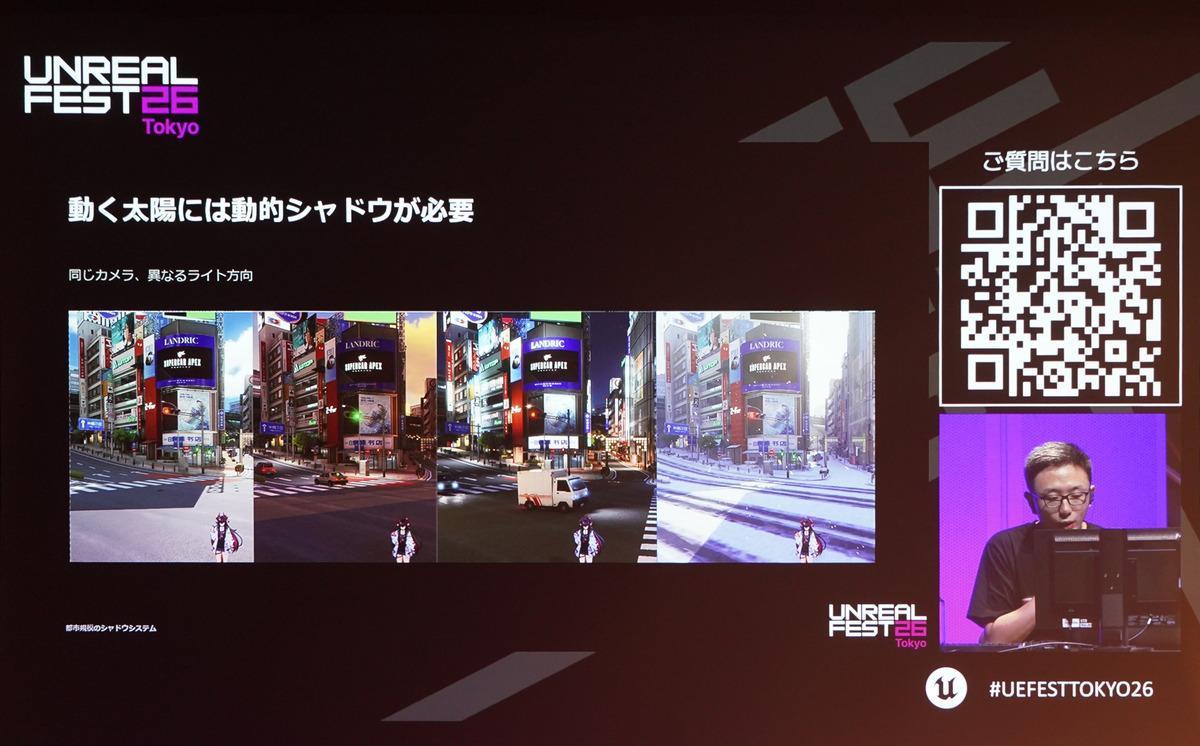
さらに、本作では昼夜に合わせて動的に影を更新する必要があります。そこで、ゲーム内の24時間を12の時間帯に分け、各区間では太陽の向きを固定 。これにより、各時間帯で処理を毎フレーム繰り返す負荷を抑えています。
時間帯の切り替え時に、太陽の向きを滑らかに遷移させている
近景の影には、PCとモバイルの双方でカスケードシャドウマップ(CSM ※)を使います。※ 影の表示範囲を複数に分け、カメラからの距離に応じて近くの影に高い精度を割り当てる手法
PC版では、CSMのキャッシュ処理を改良。カメラが移動した際には、移動前後で重なる領域を再利用し、新たに必要になった領域のみを計算 します。
移動前後で重なる部分の深度値をコピーして再利用し、新たに必要になった細い帯状の領域のみをレンダリングする
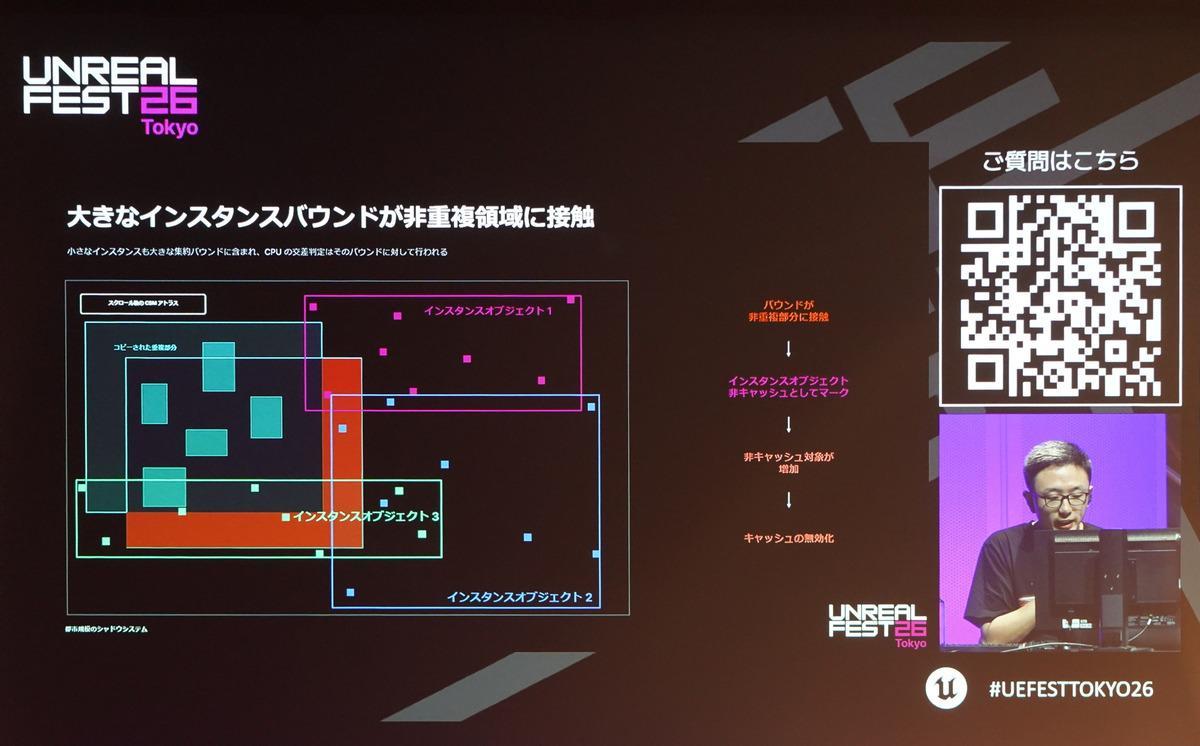
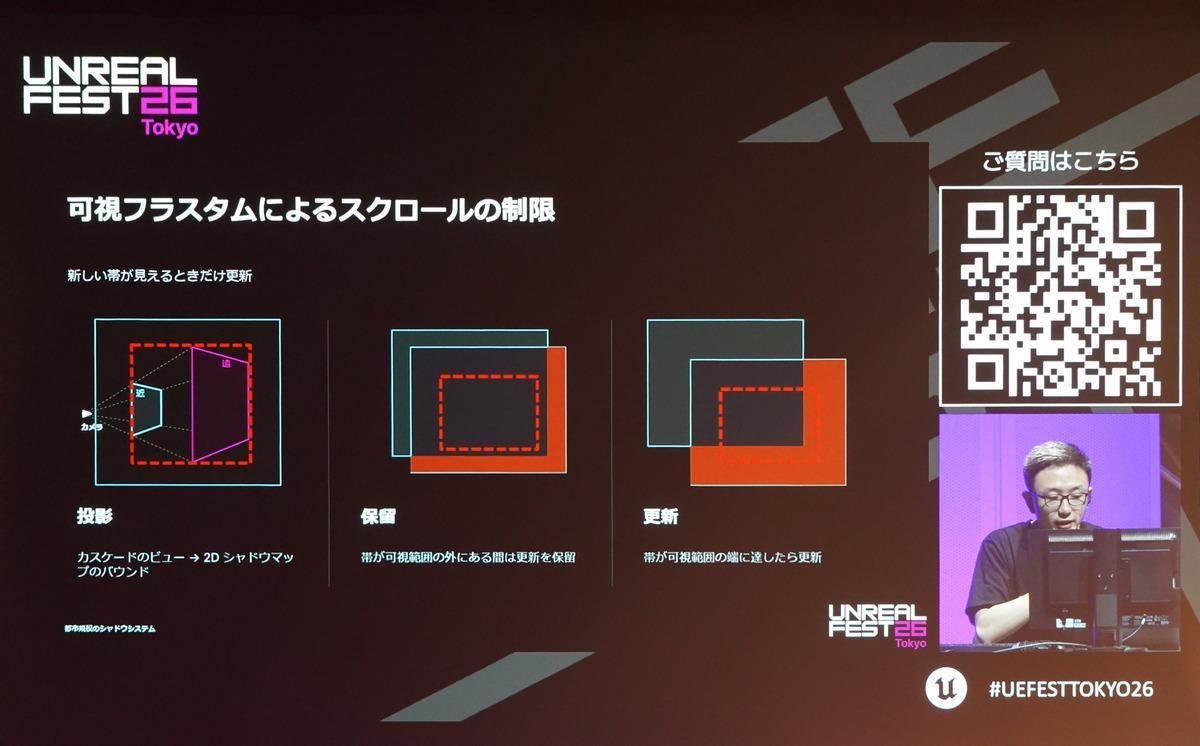
ただし、従来の処理では、画面外の領域まで計算する場合がありました。そこで、画面内の影の判定に必要な範囲を求め、それ以外の更新を必要になるまで保留 するように変更。
視錐台をシャドウマップ上へ投影し矩形で囲むことで、画面内の影を判定する際に参照し得る範囲を求める
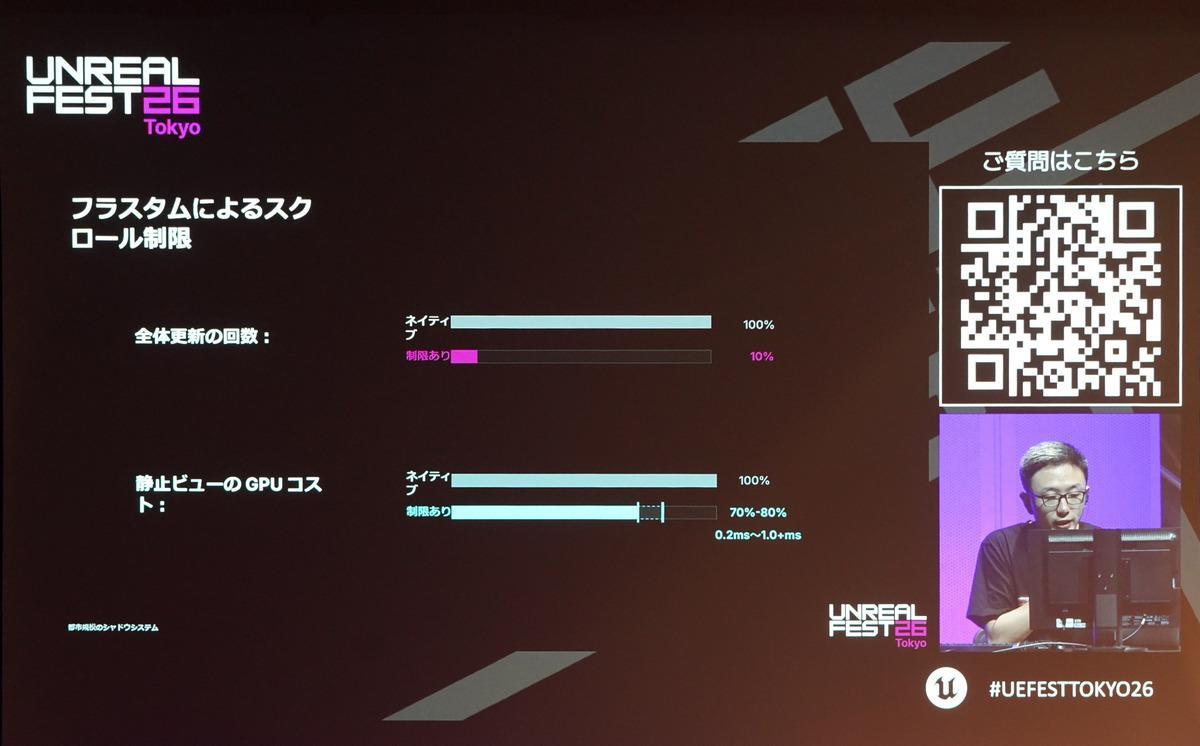
これにより、シャドウマップ全体の更新回数が約90%減り 、視点が静止した状態の影のGPU処理時間も20〜30%短縮 されたといいます。
使用するハードウェアによって、約0.2〜1ms超の短縮につながったという
モバイルの影には独自の「LSM」を利用。更新を複数フレームに分散 モバイル版で遠景までCSMを使うと、カメラの移動に伴う更新が重くなり、処理落ちにつながります。そこで、モバイル版では近景にCSM、遠景の静的な影には独自の「Layer Shadow Map(LSM)」 を使用しています。
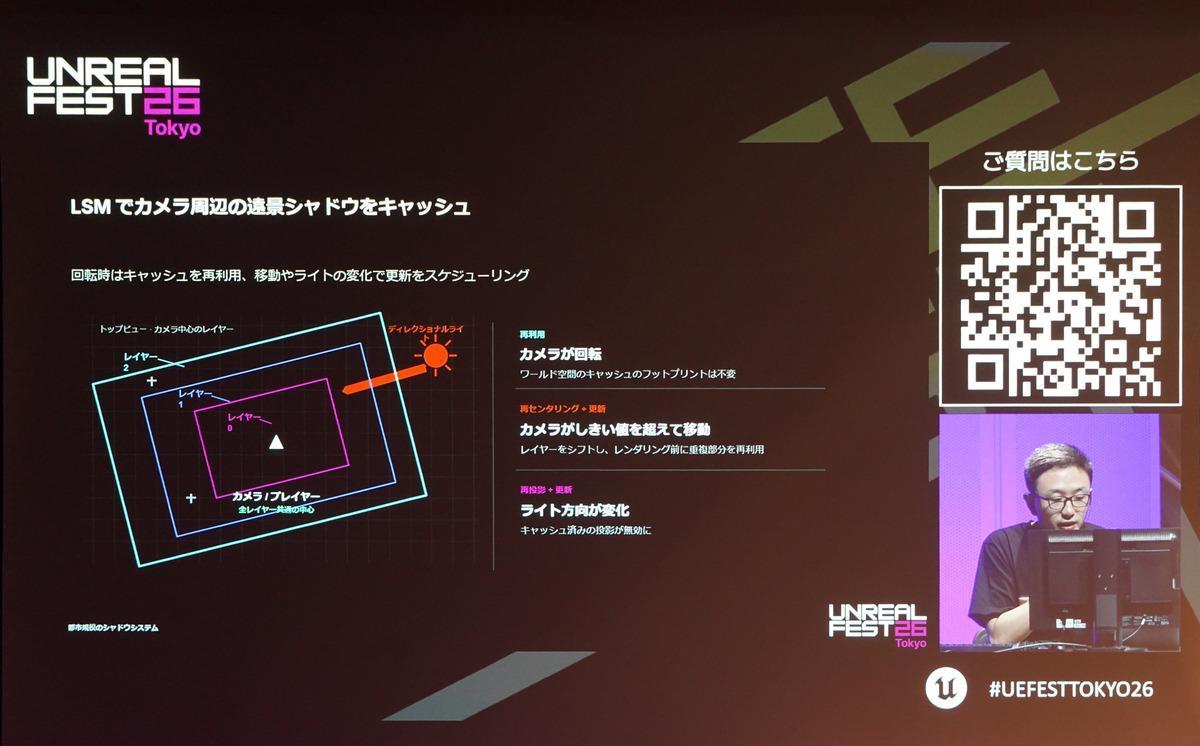
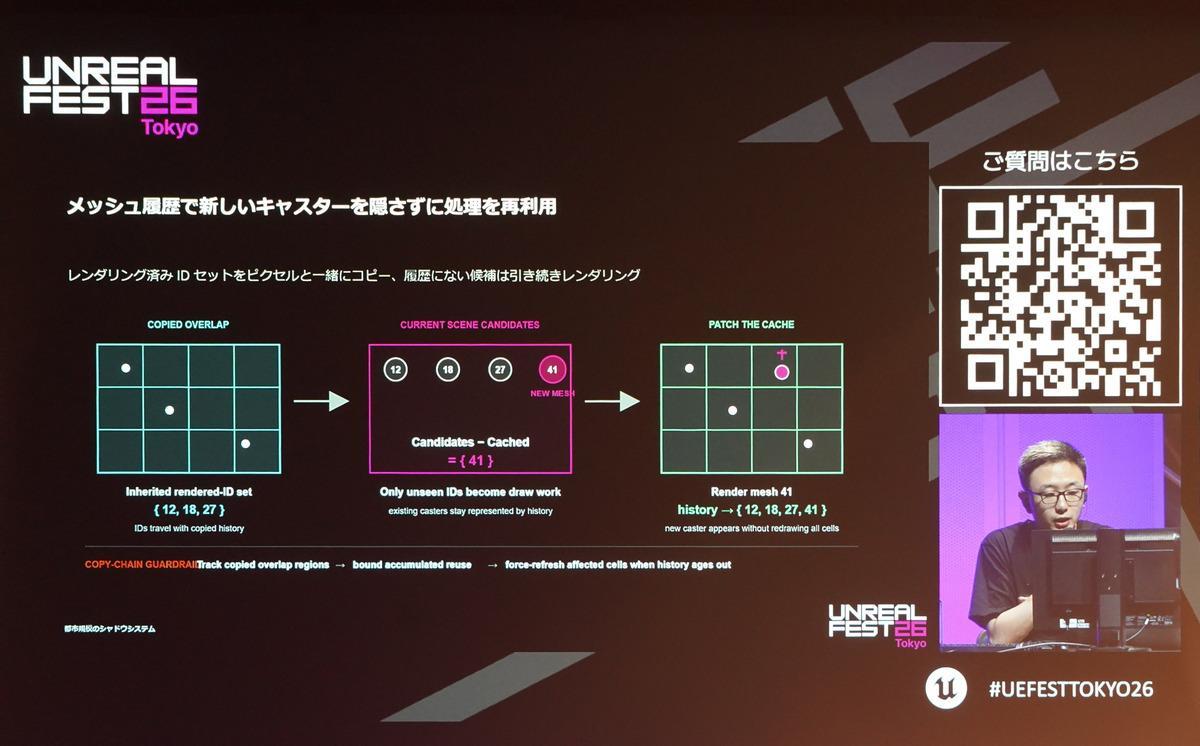
LSMはカメラ周辺の影の情報をキャッシュします。キャッシュする範囲はカメラの向きに左右されないため、カメラが回転するだけであれば保存済みの情報を使って影を描画できます。一定距離を移動した際も、以前の領域と重なる部分を使い回し、必要な部分を少しずつ描画します。
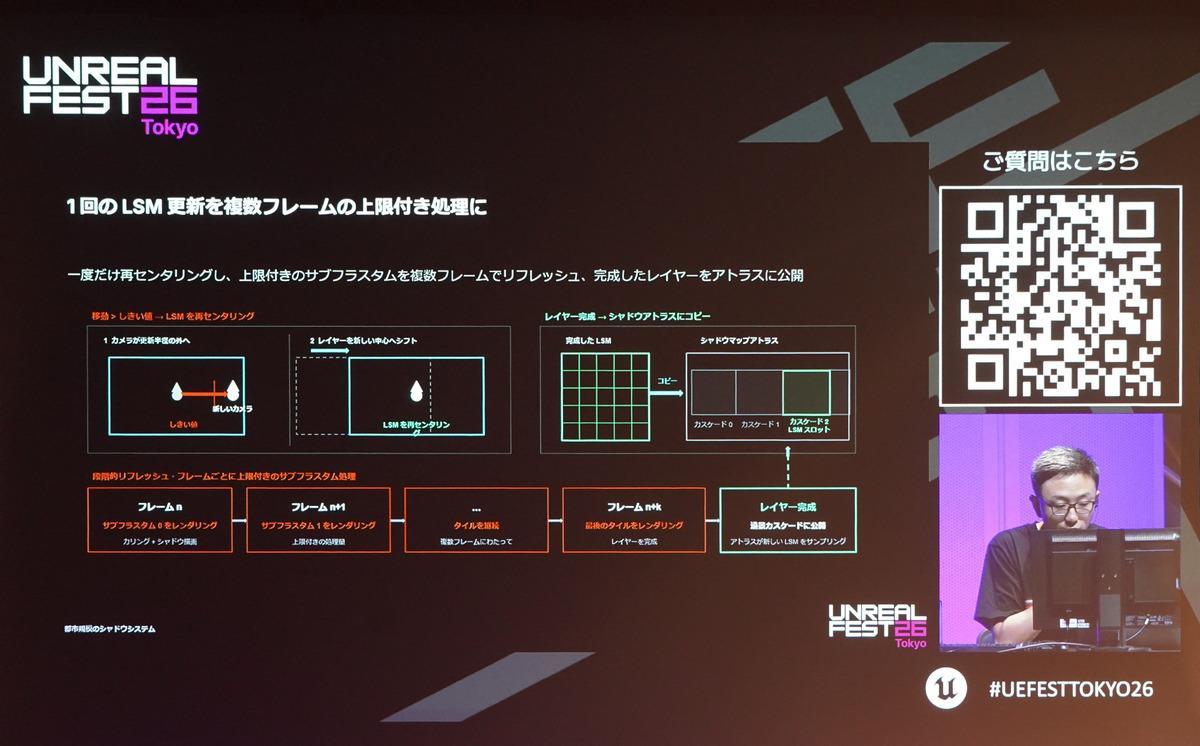
更新範囲はタイルに分割し、1フレームで処理する数を制限 。古いキャッシュが有効な間はそれを使い、新しいレイヤーの描画が完了してから差し替えることで、負荷の集中を防ぎます。
遠景での見た目への影響を考慮し、動的オブジェクトの影はLSMを使わない
カメラの平行移動によって新旧の領域が大きく重なる場合は、既存のLSMをずらして重複部分をコピーします。これにより、描画済みの情報を残しながら、新たに必要になった帯状の領域を更新できます。
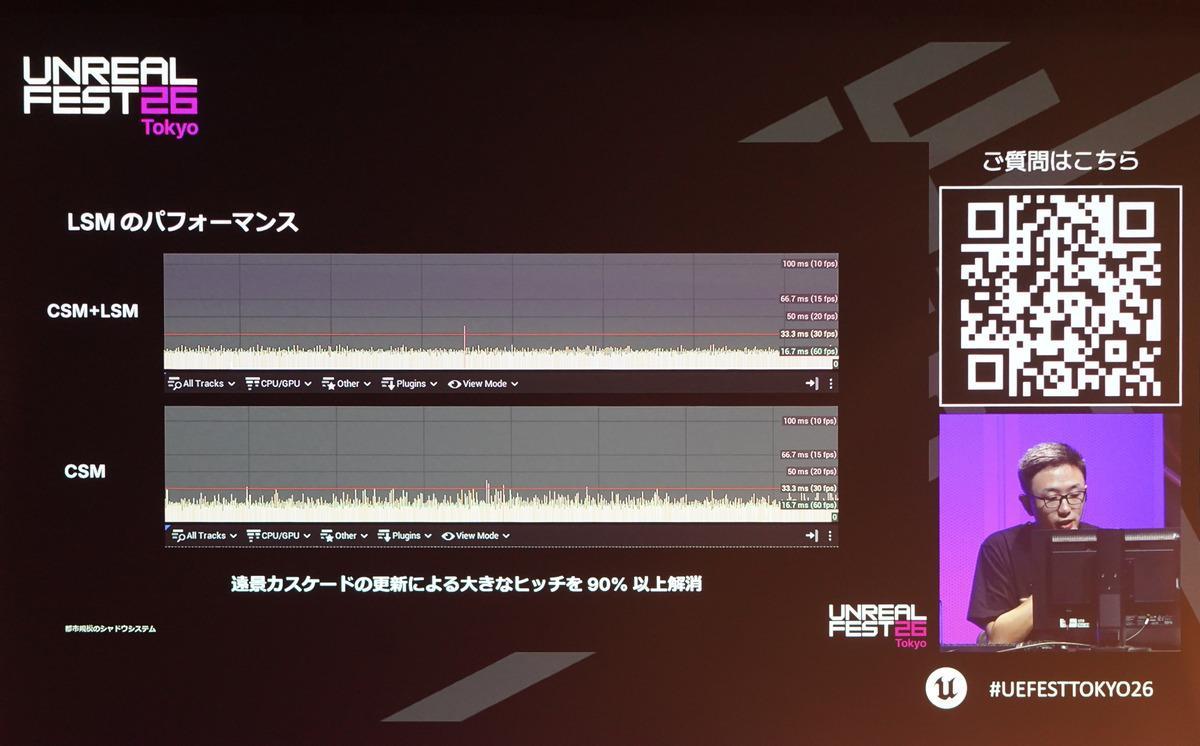
講演では、CSMとLSMの併用により、遠景の影の更新に伴う大きなヒッチを90%以上削減 したと報告されました。一方、時間帯の切り替えで太陽の向きが変わると古いキャッシュが無効になり、更新が終わるまで遠景の影が一時的に消える場合 もあるといいます。
Zheng氏は、有効な影の履歴を再利用し、更新する範囲や1フレームの作業量に上限を設ける ことが、PCとモバイルに共通する設計原則だとまとめ、講演を締めくくりました。
「Unreal Fest Tokyo 2026」公式サイト 『NTE: Neverness to Everness』公式サイト